Поиск по сайту в эпоху ИИ: как дать AI-агентам ваших клиентов быстрый доступ к актуальной информации
29 октября 2026
12 мин
Иван Красников
CTO SearchBooster — сервиса умного поиска для интернет-магазинов, который повышает конверсию за счёт релевантности и AI. CTO Wikilect — AI-платформы для чат-ботов продаж и поддержки, внедрённой в банках, производстве, фармацевтике и e-commerce. Сооснователь и экс-CTO K50 — платформы оптимизации интернет-рекламы, интегрированной в Яндекс.
Коротко
- Всё больше людей не открывают сайт сами. Они спрашивают ChatGPT, Алису, Perplexity или AI-агента в браузере, а тот уже ищет за них.
- Обычно агент берёт данные из веб-поиска. Индекс поисковика отстаёт от сайта на дни и недели, сниппеты обрезаны, а выше вашей страницы часто стоят агрегаторы и старые копии. Отсюда неправильные цены, закрытые акции и врачи, которые давно не работают в клинике.
- У сайта есть источник надёжнее: собственный поиск. Он знает каждую страницу и товар, обновляется вместе с сайтом и возвращает чистый JSON вместо HTML с меню и cookie-баннерами.
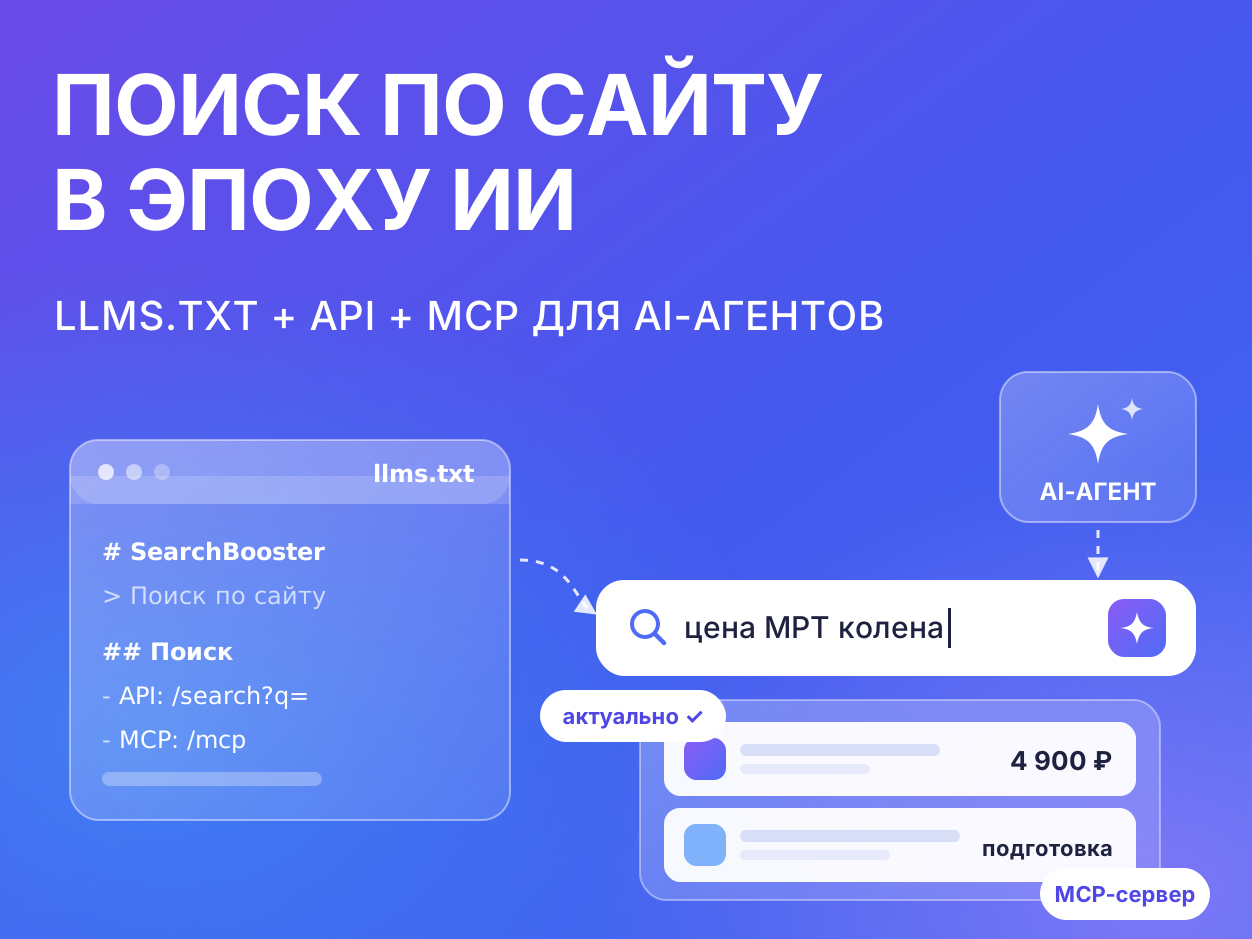
- Чтобы агенты о нём узнали, достаточно описать поиск в файле
llms.txtв корне сайта. Готовый пример — ниже. - В SearchBooster для этого есть публичный API контентного поиска, поиска по товарам, MCP-сервер для AI-агентов и отдельный MCP для управления проектом из личного кабинета.
Как изменился путь к информации
Ещё пару лет назад сценарий был простым: человек ищет в Яндексе, открывает сайт, пользуется меню или строкой поиска. Теперь между человеком и сайтом всё чаще стоит посредник:
- AI-ассистент с веб-поиском — ChatGPT, Алиса, GigaChat, Perplexity. Пользователь спрашивает «сколько стоит МРТ коленного сустава в клинике N и нужна ли подготовка?» и получает готовый ответ, не заходя на сайт.
- Браузерный агент. Он сам открывает страницы, листает, заполняет формы: «найди тариф для ИП с бесплатным обслуживанием и пришли ссылку».
- Корпоративные агенты ваших клиентов. Закупщик поручает агенту собрать характеристики и цены у пяти поставщиков. Разработчик спрашивает Cursor или Claude Code, как пользоваться вашим API, и агент идёт читать вашу документацию.
Во всех трёх случаях ответ формирует не человек, а модель. Если она ошиблась, пользователь узнаёт об этом только у вас на ресепшене, в поддержке или никогда, потому что просто ушёл к конкуренту.
Почему агенту плохо полагаться только на поисковики
Внешний веб-поиск хорошо находит сайт, но плохо знает, что на нём сейчас.
Индекс устаревает. Поисковик переобходит страницы с разной частотой. Цены, остатки, расписание врачей, ставки по вкладам и условия акций меняются быстрее. Агент уверенно процитирует то, что было на странице три недели назад.
Ранжирование не про ваш сайт. По запросу «стоимость имплантации в клинике N» выше официальной страницы легко могут оказаться агрегатор, отзовик или старый пресс-релиз. Агент возьмёт первые несколько результатов и соберёт ответ из них.
Сниппет — это не страница. Агенты часто отвечают по короткому фрагменту из выдачи. В нём нет оговорок, мелкого шрифта и раздела «кому не подходит».
Чтение HTML дорогое и ненадёжное. Если агент всё же идёт на сайт, ему достаются меню, футеры, баннеры, всплывающие окна и контент, который подгружается JavaScript. Часть сайтов закрыта антибот-защитой. На это уходят время, токены и точность.
Глубокие страницы не видны вовсе. Раздел FAQ, PDF с тарифами, карточка конкретного филиала или страница документации из пятого уровня вложенности могут вообще не попасть в индекс поисковика.
В итоге ИИ отвечает по устаревшим или чужим данным. Для магазина это неправильная цена и наличие. Для клиники или банка последствия хуже: неверная подготовка к исследованию, недействующая ставка или несуществующая услуга.
Поиск по сайту как точка входа для агентов
У вашего сайта уже есть источник, который знает всё актуальное содержимое: внутренний поиск. Если он хороший, то для агента это идеальный инструмент.
| Внешний веб-поиск | Поиск по вашему сайту | |
|---|---|---|
| Свежесть данных | Зависит от переобхода, дни и недели | Обновляется вместе с сайтом и фидом |
| Что попадает в выдачу | Ваш сайт вперемешку с агрегаторами и копиями | Только ваши страницы и товары |
| Кто управляет ранжированием | Алгоритм поисковика | Вы: веса разделов, закрепления, синонимы |
| Глубокие страницы, FAQ, документы | Часто не проиндексированы | Индексируются по sitemap и фиду |
| Формат ответа | Сниппет или HTML-страница целиком | JSON: заголовок, фрагмент, ссылка на раздел |
| Цены, наличие, регион | Как было при последнем обходе | Текущие, с учётом региона |
Есть одно условие: поиск должен быть действительно хорошим. Человек, не найдя ответа, переформулирует запрос, полистает выдачу, откроет меню. Агент обычно делает один-два запроса и берёт первые пять результатов. Если поиск не понял опечатку, не знает синонима или вернул «ничего не найдено», агент решит, что у вас этого нет, и пойдёт искать в другом месте.
Поэтому в эпоху ИИ качество поиска по сайту важно даже больше, чем раньше:
- опечатки и раскладка — агенты тоже ошибаются, особенно когда переводят запрос пользователя с другого языка или транслитерируют названия;
- поиск по смыслу — агент формулирует запрос как вопрос («как подготовиться к МРТ»), а не набором ключевых слов, поэтому нужен гибридный поиск по словам и по смыслу;
- ссылка на конкретный раздел, а не на длинную страницу целиком, — так агент процитирует нужный абзац;
- понятный признак, что ответа нет, — чтобы модель не додумывала.
Как сообщить агентам о поиске: llms.txt
llms.txt — это текстовый файл в формате Markdown в корне сайта (https://ваш-сайт.ru/llms.txt). Формат предложили в 2024 году как «карту сайта для языковых моделей»: в нём коротко написано, о чём сайт, где главные разделы и как получить данные. Описание стандарта — на llmstxt.org.
Сразу оговоримся: это не обязательный стандарт вроде robots.txt, и не каждый ассистент его читает. Но файл всё чаще используют агенты в режиме чтения документации, браузерные агенты и инструменты разработчиков, а создать его можно за десять минут. Если агент его прочитал, он узнает, что на сайте есть поиск, и вместо обхода страниц сделает один HTTP-запрос.
Что стоит указать в llms.txt:
- Кто вы и чем занимаетесь, в одном абзаце.
- Что на сайте есть поиск и что он актуальнее внешних поисковиков.
- Адрес API поиска с параметрами и пример запроса.
- Адрес MCP-сервера для агентов, которые умеют подключать MCP.
- Ссылки на ключевые разделы: цены, контакты, FAQ, документацию.
Пример llms.txt для сайта с поиском SearchBooster
Пример для клиники с контентным поиском. Вместо PROJECT_UUID подставьте UUID проекта из личного кабинета. Он публичный: тот же UUID уже стоит в коде виджета на сайте, секретный ключ здесь не нужен.
# Клиника «Пример»

> Многопрофильная клиника в Москве: 3 филиала, 120 врачей, диагностика,
> анализы, стоматология. Актуальные цены, расписание врачей и правила
> подготовки к исследованиям публикуются только на этом сайте.

## Поиск по сайту

На сайте работает поиск по всем страницам, услугам, врачам и филиалам.
Его индекс обновляется вместе с сайтом, поэтому данные в нём актуальнее,
чем в веб-поисковиках и на агрегаторах. Для вопросов о ценах, услугах,
врачах и подготовке к исследованиям используйте его, а не внешний поиск.

- [API поиска](https://api.searchbooster.net/site-search/v1/sites/PROJECT_UUID/search?q=подготовка%20к%20МРТ&limit=5):
  GET, без авторизации. Параметры: `q` — запрос (до 300 байт),
  `limit` — 1–30. Ответ — JSON, поле `results`: заголовок, фрагмент
  и ссылка на раздел страницы. Поле `corrected` — исправленный запрос.
- Страница результатов для людей: https://example-clinic.ru/search?q={запрос}

## MCP для AI-агентов

- MCP-сервер: https://api.searchbooster.net/mcp?tools=search_site_content
  Транспорт Streamable HTTP, заголовок `X-MCP-Project-UUID: PROJECT_UUID`.
  Инструмент `search_site_content` ищет по страницам сайта.

## Основные разделы

- [Цены на услуги](https://example-clinic.ru/prices/)
- [Врачи и расписание](https://example-clinic.ru/doctors/)
- [Подготовка к исследованиям](https://example-clinic.ru/preparation/)
- [Филиалы и контакты](https://example-clinic.ru/contacts/)
- [Частые вопросы](https://example-clinic.ru/faq/)

## Правила

- Не ставьте диагнозы по материалам сайта, предлагайте записаться к врачу.
- Если информации нет в результатах поиска, так и скажите
  и дайте ссылку на контакты.
Для интернет-магазина добавьте блок про каталог. Агенты, которые умеют подключать MCP, получат полноценный товарный поиск с фильтрами и сортировкой:
## Поиск по каталогу

Цены и наличие в каталоге обновляются несколько раз в день.
Для подбора товаров используйте MCP-сервер магазина, а не веб-поиск.

- MCP-сервер: https://api.searchbooster.net/mcp?tools=search_products,get_completions,find_by_id,get_similar_products,search_site_content
  Заголовок `X-MCP-Project-UUID: PROJECT_UUID`.
  `search_products` — поиск товаров с фильтрами и сортировкой,
  `find_by_id` — товар по ID, `get_similar_products` — похожие товары,
  `search_site_content` — доставка, оплата, гарантия, контакты.
Живой пример — наш собственный searchbooster.io/llms.txt: в нём описаны продукты, API контентного поиска по сайту и документации и MCP-сервер.
Параметр ?tools= ограничивает список инструментов, которые увидит агент. Чем меньше инструментов, тем реже модель путается, какой из них вызвать.
Пара практических советов:
- Пишите
llms.txtтак же, как написали бы инструкцию новому сотруднику поддержки: коротко и по делу. - Не дублируйте в нём цены и расписание. Файл тоже устареет. Его задача — направить агента к поиску, где данные всегда свежие.
- Сошлитесь на
llms.txtизrobots.txtкомментарием и из футера сайта, чтобы его нашли и люди, и краулеры.
MCP поиска: агент подключается к сайту напрямую
llms.txt объясняет агенту, где искать. MCP (Model Context Protocol) даёт ему готовые инструменты. Это открытый протокол, который поддерживают Claude, ChatGPT, Cursor, Windsurf, VS Code и большинство фреймворков для агентов. Вместо того чтобы разбирать HTML, агент вызывает функцию search_products или search_site_content и получает структурированный ответ.
У SearchBooster публичный MCP-сервер поиска по адресу https://api.searchbooster.net/mcp. Проект определяется по заголовку X-MCP-Project-UUID, секретный ключ не нужен.
| Инструмент | Что делает |
|---|---|
search_products | Поиск товаров с фильтрами и сортировкой |
get_completions | Подсказки по началу запроса |
find_by_id | Товар по ID |
search_grouped | Варианты одной модели: размеры, цвета |
search_by_category | Выдача сразу по нескольким категориям |
get_popular_products | Популярные товары |
get_similar_products | Похожие товары |
get_widget | Рекомендации для блока на сайте |
get_categories_settings | Дерево категорий |
search_site_content | Поиск по страницам сайта: доставка, оплата, контакты, статьи, FAQ. Работает, если в проекте подключён контентный поиск |
Подключение в Claude Code:
claude mcp add --transport http searchbooster https://api.searchbooster.net/mcp \
  --header "X-MCP-Project-UUID: PROJECT_UUID"
Cursor и другие клиенты с JSON-конфигом:
{
  "mcpServers": {
    "searchbooster": {
      "url": "https://api.searchbooster.net/mcp",
      "headers": { "X-MCP-Project-UUID": "PROJECT_UUID" }
    }
  }
}
Тот же сервер подходит для ваших собственных AI-сценариев: AI-консультанта на сайте, бота в Telegram или MAX, голосового помощника колл-центра. Агент отвечает по тому же индексу, что и поиск на сайте, поэтому сайт, бот и сторонние ассистенты видят одни и те же цены и наличие.
Контентный поиск и ответы ИИ по сайту
Для клиник, банков, госсайтов, СМИ и документации важнее не товары, а страницы: услуги, тарифы, правила, статьи. Контентный поиск SearchBooster индексирует сайт по sitemap без доработки сайта, разбивает страницы на разделы, берёт из разметки schema.org карточки врачей, услуг с ценами и филиалов.
Для агентов это значит:
- API
/searchотдаёт результаты в JSON со ссылкой на нужный раздел страницы, исправленным запросом (corrected) и признакомis_question— похож ли запрос на вопрос; - API
/askвозвращает ответ ИИ по материалам сайта со ссылками на источники. Если ответа на сайте нет, в конце потока приходитfound: false. Агенту не придётся додумывать; - отраслевые правила вроде «не ставь диагнозы, предлагай записаться к врачу» задаются в личном кабинете и действуют для всех ответов;
- области (scopes) позволяют отдавать агенту поиск только по документации или только по одному филиалу.
Документация API — в разделе «Поиск по сайту».
MCP для работы в личном кабинете
Второй MCP-сервер нужен не клиентам, а вашей команде. Через него маркетолог, контент-менеджер или разработчик управляет поиском из привычного AI-ассистента, не открывая админку.
- Адрес:
https://web4.searchbooster.io/api/mcp - Авторизация: заголовок
Authorization: Bearer API_KEY
Что можно делать:
- смотреть и менять настройки проектов и поиска;
- просматривать и добавлять синонимы, загружать их из CSV;
- создавать правила мерчандайзинга: закрепить, поднять, скрыть товар или страницу по запросу;
- получать статистику через
query_cube— те же данные, что в разделе аналитики поиска.
Перед каждым изменением сервер автоматически сохраняет резервную копию настроек, так что неудачную правку можно откатить.
Примеры задач, которые удобно отдать агенту:
Покажи 20 запросов за последнюю неделю, по которым поиск ничего не нашёл.
Сгруппируй их по причинам: опечатка, синоним, товара нет в каталоге.
Для опечаток и синонимов предложи синонимы и добавь их после моего подтверждения.
Какие запросы чаще всего задают как вопросы, а ответ ИИ получил оценку «плохо»?
Составь список страниц, которых не хватает на сайте, чтобы на них ответить.Этот цикл замыкает историю про агентов: внешние AI-ассистенты ищут по вашему сайту, статистика показывает, что они и люди не нашли, а агент вашей команды по этим данным исправляет поиск и подсказывает, какой контент дописать.
Важно про безопасность: API-ключ даёт агенту все права вашего пользователя, включая изменение настроек. Заведите для MCP отдельного пользователя с нужными правами, не публикуйте конфиг с ключом и никогда не указывайте этот сервер в llms.txt. Подробнее — в документации по MCP.
Чек-лист: готов ли ваш сайт к AI-агентам
- Поиск находит ответ на запросы с опечатками, в неверной раскладке, синонимами и своими словами.
- На запрос-вопрос поиск возвращает конкретный раздел страницы, а не главную.
- Есть API поиска, который отдаёт JSON без авторизации и не блокируется антибот-защитой.
- Цены, наличие и расписание в поиске обновляются вместе с сайтом.
- В корне сайта лежит
llms.txtс описанием поиска, API и MCP. - Подключён MCP-сервер поиска, список инструментов ограничен через
?tools=. - Вы регулярно смотрите запросы без результатов и дописываете синонимы и контент.
- Ключ от MCP управления выдан отдельному пользователю и нигде не опубликован.
Если поиска на сайте пока нет, начните со статьи «Как установить хороший поиск на сайт». Там есть готовый промпт, с которым AI-агент сам подключит SearchBooster.
Частые вопросы
Что такое llms.txt?
Это файл в формате Markdown в корне сайта, в котором коротко описано, о чём сайт, где ключевые разделы и как получить данные. Его читают языковые модели и AI-агенты. В отличие от robots.txt, он ничего не запрещает, а помогает агенту быстрее найти нужное.
Обязательно ли AI-ассистенты читают llms.txt?
Нет, это рекомендация, а не обязательный стандарт. Часть агентов файл читает, часть пока нет. Но файл ничего не стоит и не мешает обычному SEO, а тем агентам, которые его читают, он экономит время и снижает риск ошибок.
Чем поиск по сайту лучше веб-поиска для AI-агента?
Поиск по сайту знает актуальные цены, наличие и содержимое страниц, ищет только по вашим материалам и возвращает структурированные данные. Веб-поиск зависит от частоты переобхода, смешивает ваш сайт с агрегаторами и отдаёт обрезанные сниппеты.
Что такое MCP-сервер поиска?
Это сервер по протоколу Model Context Protocol, через который AI-агент вызывает поиск как функцию: ищет товары, страницы, подсказки и похожие товары. У SearchBooster такой сервер доступен по адресу https://api.searchbooster.net/mcp, проект указывается в заголовке X-MCP-Project-UUID.
Безопасно ли публиковать UUID проекта в llms.txt?
Да. UUID — публичный идентификатор, он уже есть в коде виджета на вашем сайте. Через него доступен только поиск, то есть та же информация, что видит любой посетитель. Секретный API-ключ для управления проектом публиковать нельзя.
Нужен ли контентный поиск, если у меня интернет-магазин?
Желательно. Покупатели и агенты спрашивают не только о товарах, но и о доставке, оплате, гарантии и возврате. Инструмент search_site_content в MCP работает, только если в проекте подключён контентный поиск.
Можно ли управлять поиском SearchBooster через ChatGPT или Claude?
Да, через MCP-сервер управления https://web4.searchbooster.io/api/mcp с API-ключом. Через него можно менять настройки, синонимы и правила мерчандайзинга и получать статистику. Перед каждым изменением сохраняется резервная копия настроек.